RDS DuckDB实例在保持MySQL协议不变的前提下引入DuckDB列式存储引擎。本文介绍DuckDB的高效写入原理以及SQL直接写入和DTS同步等场景下的高性能写入方法与建议,帮助您获得更高的入库吞吐、更稳定的写入延迟和更可控的资源成本。
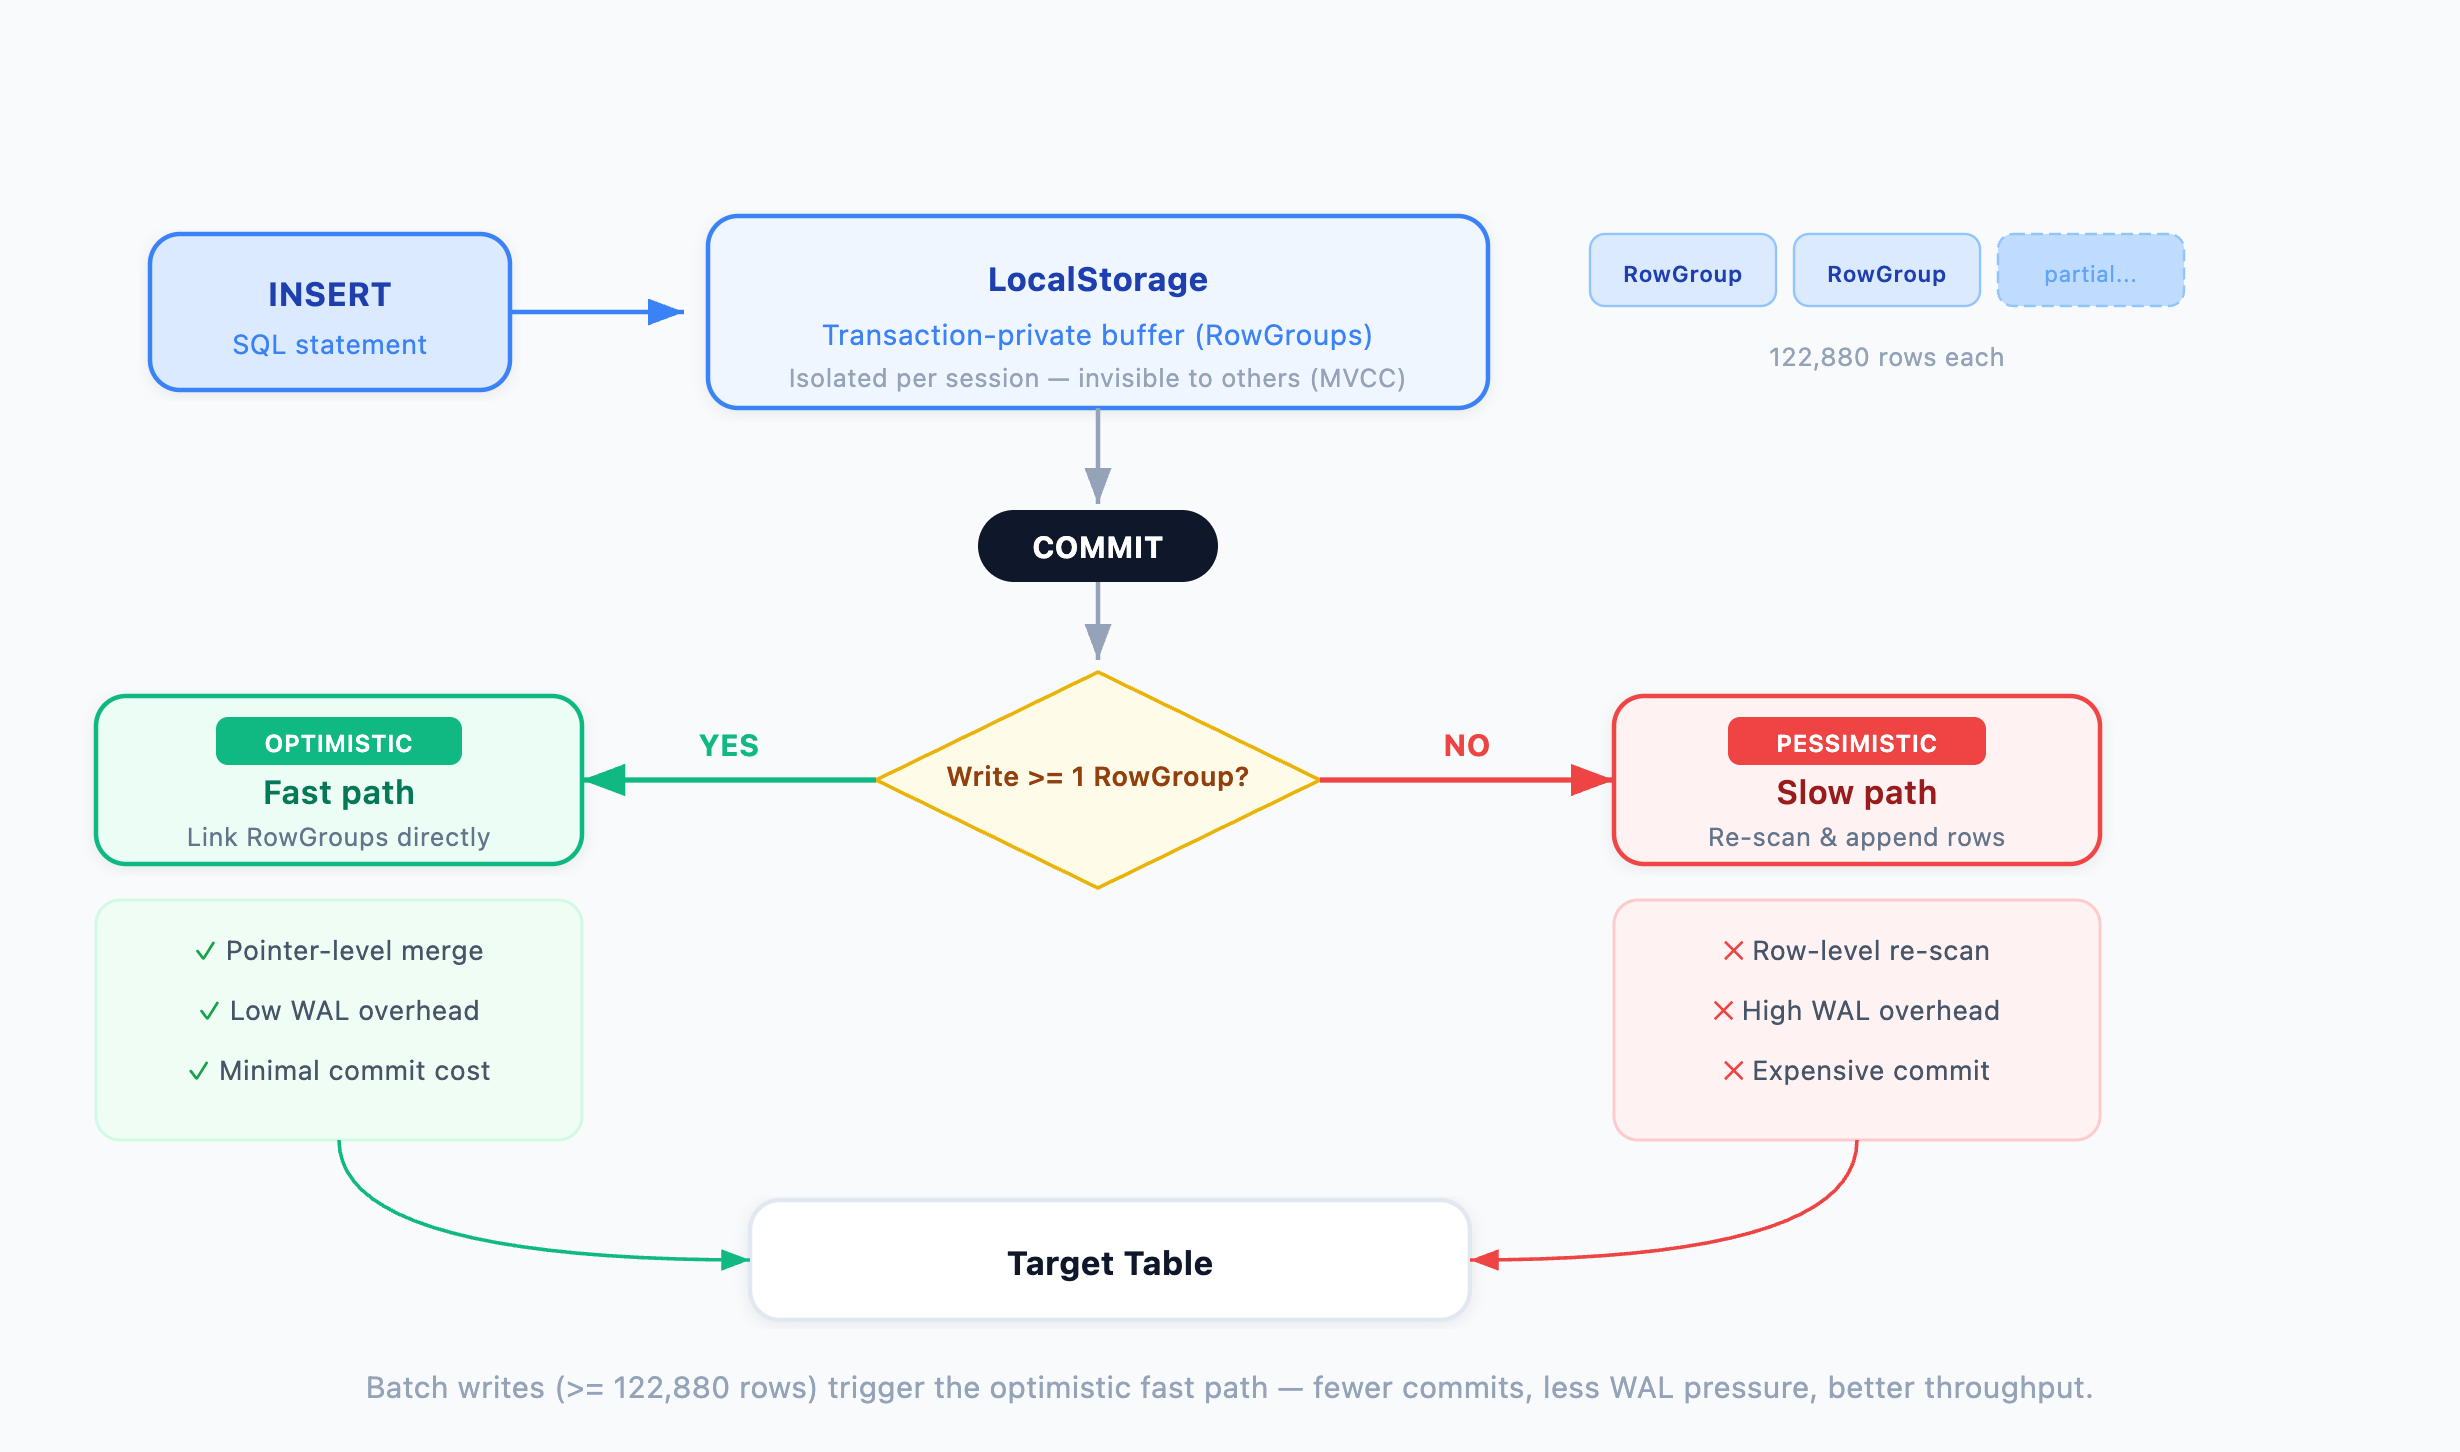
在AI与数据驱动的业务背景下,数据规模与分析需求持续增长:越来越多的明细、日志与历史数据需要被长期保留,用于报表分析、运营洞察与问题追溯;同时,用户也希望尽量沿用既有的MySQL接入方式、权限体系与运维手段,降低迁移与学习成本。RDS DuckDB实例在保持MySQL协议与使用习惯不变的前提下,引入列式存储引擎DuckDB,为归档与分析场景提供更高的压缩率与更强的分析性能。 DuckDB的列式存储在数据组织与持久化机制上与传统行存引擎不同,如果仍采用大量小事务、频繁提交或随机写入等模式,往往难以发挥列式引擎在批量构建与压缩方面的优势,并可能导致写入延迟波动、同步积压与资源利用率下降等问题。此外,DuckDB以MySQL插件式存储引擎的形态集成到RDS MySQL体系后,数据写入的方式远比原生的DuckDB丰富。用户可以沿用MySQL生态的多种写入链路将数据导入实例,包括SQL直接写入、DTS全量与增量同步以及其他基于MySQL协议的数据写入工具。 本文将结合DuckDB的写入特性与RDS MySQL的集成能力,介绍RDS DuckDB高效写入原理,不同场景下的高性能写入方法与建议,帮助用户获得更高的入库吞吐、更稳定的写入延迟和更可控的资源成本。 与传统行存引擎相比,DuckDB的写入与修改行为存在显著差异。对于INSERT,DuckDB在事务执行期间不会直接改写目标表,而是将新增数据写入当前事务私有的LocalStorage。该机制使并发会话的写入彼此隔离,通常无需围绕目标表进行频繁同步;事务回滚时也只需清理本事务的LocalStorage。同时,未提交数据对其他会话不可见,能够满足MVCC的可见性要求。 在事务提交阶段,DuckDB会将LocalStorage中的RowGroupCollection汇入目标表,而汇入路径则与写入规模密切相关: 乐观汇入路径:当满足以下条件时,写入会进入乐观汇入路径:目标表为空,或本次写入达到一个RowGroup(默认122880行),且未发生对本次插入数据的删除回滚。写入过程中写满的RowGroup会逐步持久化,提交时通过将已落盘的RowGroup直接链接到目标表结构完成合并;同时WAL仅需记录持久化数据的指针或元信息,从而降低写入放大并减少提交阶段开销。 悲观路径:若写入规模较小或条件不满足,则会进入悲观路径,需要重新扫描并按向量块(默认2048行)追加到目标表,WAL也需要记录更多实际数据。当WAL持续增长时,系统通常会更频繁地触发Checkpoint,将内存中的变更推进到持久化状态。Checkpoint会引入额外的落盘与元数据处理开销,并可能与前台读写产生资源竞争,从而带来写入延迟波动或吞吐下降。 基于上述机制,DuckDB更适合批量且低频提交的写入模式;单次插入尽量达到或超过一个RowGroup的规模,更有利于触发高效的汇入与日志路径,并降低WAL写放大与Checkpoint频率对整体读写的影响。 图1:DuckDB INSERT的写入过程 对于UPDATE/DELETE,DuckDB通常以向量块为单位执行,并通过版本信息与Undo/WAL维护事务一致性。实践中,若业务语义允许,可以将部分UPDATE改写为DELETE + INSERT组合,并将删除与插入尽量组织为批量操作、减少事务提交次数,以获得更稳定的吞吐与延迟表现。 RDS MySQL设计了专用于DuckDB引擎的数据导入模式,在DuckDB的写入链路上引入一套受限且可幂等的导入语义,用来保证导入过程高效可控,并避免重复写入带来的脏数据问题。它由两个参数协同构成: 参数 UPDATE被完全禁止,要求调用方以DELETE + INSERT的形式替代UPDATE操作。 DELETE被限制为仅允许按完整主键逐字段等值匹配的精确删除,不再支持范围条件、函数、OR子句或子查询等复杂形式,系统直接调用存储引擎接口执行精确行删除。 此外,该参数的状态会随binlog一同传递到从库,使主从回放行为相同,避免执行模式不一致。 在此基础上,参数 图2:数据导入模式下数据流转过程 在数据导入模式下,单个事务中所有满足要求的插入、删除操作会被汇聚在临时的数据记录表中,提交时将所有修改一次性写入目标表。幂等模式下,DuckDB引擎会引入额外删除操作,在逐行写入时体现为每条INSERT多一次基于主键的点删除,在批处理时体现为每次提交多一次批量删除查询。因此在实际使用中,该模式本质上是一种面向数据导入的优化模式,适合快速、批量的数据导入场景。 在RDS MySQL场景下,DuckDB的批量写入模式通常意味着更大的事务规模。而RDS MySQL本身具备大事务提交优化和大事务实时应用等能力,可以显著缓解大事务引发的复制延迟与性能抖动,非常适合承载DuckDB的攒批写入模型。同时,RDS MySQL还对DuckDB的压缩链路进行了工程化优化,包括复用列级别编码压缩策略、降低压缩关键路径锁竞争,以及结合采样与并行流水线提升压缩吞吐,进一步改善写入与数据构建阶段的吞吐和稳定性。 为了更好地发挥RDS DuckDB引擎在批量写入场景下的吞吐能力,同时降低重复执行带来的数据冗余风险,建议在导入、定时同步等场景中,使用幂等的数据导入模式来执行攒批写入。 参数 级别 默认值 说明 全局 ON 控制DML操作是否使用攒批方式写入DuckDB。 会话 OFF 控制是否开启数据导入模式。 全局 ON 控制数据导入过程中是否开启幂等导入。 在上述配置下,系统会采用批量化写入的方式组织DML操作,典型的使用流程如下: 在控制台设置参数 开始攒批写入。 重要 当前RDS DuckDB分析主实例不具备主键/唯一键约束的能力,因此数据的唯一性需要业务侧自行保证。 当前RDS DuckDB分析主实例不支持自增能力,业务侧需自行生成相关字段取值。 开启数据导入模式后,UPDATE操作将被禁止,业务侧需将UPDATE改写为DELETE + INSERT。 开启数据导入模式后,DELETE仅支持单一主键或联合主键的等值条件过滤,不支持范围或非主键条件或更复杂的谓词形式。 在数据同步、定时任务以及存在失败重试的场景中,建议开启幂等导入,以避免重复执行导致数据冗余。 从性能实践角度看,为了尽可能发挥DuckDB的批量写入能力,建议单次单表插入量尽量超过一个RowGroup(默认122880行),以触发乐观汇入路径,降低WAL写放大与Checkpoint开销。 在并发控制上,建议攒批模式下,同一时间仅有一个线程操作一张表,以降低冲突和额外协调成本。 除攒批外,也可考虑在单条SQL中尽量合并更多数据,例如使用单条INSERT写入多行,或让单条DELETE/UPDATE覆盖更多目标记录,从而减少事务提交次数、提升整体写入吞吐。 为评估普通逐行写入模式与数据导入模式的性能差异,本文在16张sysbench表、16个并发线程的配置下,对Insert、Delete和Update三类操作的平均QPS进行了对比测试。其中,数据导入模式下的Update语义通过DELETE + INSERT的方式实现,每个线程只负责更新一张表,每次攒批行数为20万行。 图3:普通写入模式和数据导入模式性能对比 测试结果表明,数据导入模式在三类操作上的平均QPS均显著高于普通的逐行写入模式,整体吞吐提升可达几十至上百倍。相较于普通逐行写入路径,数据导入模式能够更充分地利用DuckDB在批量执行上的性能优势,从而获得更高、更稳定的写入吞吐。因此,对于批量导入、历史数据回灌、同步重放以及存在重复执行风险的任务,建议开启 在数据导入模式的基础上,RDS DuckDB实例已与阿里云DTS深度集成,支持将MySQL数据实时同步至DuckDB,覆盖全量导入与增量同步两个阶段。 为充分复用数据导入模式的攒批写入能力,DTS在同步链路上对DML操作进行了统一收敛:所有写入操作仅保留DELETE和INSERT两种形式,其中UPDATE在DTS侧被自动改写为DELETE + INSERT,DELETE的条件形式固定为完整主键等值匹配,与数据导入模式对DELETE语义的要求完全对齐。 在并发控制上,DTS按表维度拆分事务,同一时刻仅由一个线程操作同一张表,避免并发写入引发数据冲突。若某批操作执行失败,DTS会自动重试该批操作。结合幂等导入机制,重试过程不会产生重复数据,保证同步结果的正确性。 在事务提交层面,数据写入RDS DuckDB引擎的过程中先经由临时表缓冲,事务提交时再统一回写至目标表;若提交失败,则重新应用当前批次的全部操作,确保数据的一致性与完整性。 图4:DTS同步到RDS DuckDB原理 基于Sysbench数据集对DuckDB作为同步目标端的写入性能进行了基准测试,结果如下: 同步阶段 全量导入 DTS增量同步 峰值吞吐 约200万行/秒 约30万行/秒 说明 实际同步速度受多种因素影响,包括源端实例的查询效率、表结构复杂度以及DTS实例规格等,上述数值为理想测试环境下的端到端性能参考值,不代表所有场景下的实际表现。 RDS DuckDB实例已与阿里云DTS完成深度集成,底层的参数配置、攒批策略与幂等控制均已自动配置。用户在创建DTS同步任务时,只需将目标数据库类型选择为DuckDB,即可自动获得高效的入库性能,无需手动进行参数配置与性能调优,大幅降低数据迁移与实时同步的接入成本。详情请参见同步MySQL实例数据至DuckDB分析主实例。 RDS DuckDB在保持MySQL协议、访问方式和运维习惯基本不变的前提下,引入DuckDB列式引擎,为归档分析、历史数据留存和高吞吐入库场景提供了更优的存储压缩率与分析性能。基于DuckDB的写入特点,RDS DuckDB提供了幂等的数据导入能力,并结合RDS MySQL在大事务优化、复制应用和压缩链路上的工程能力,形成了一套适合高吞吐写入与同步导入的完整方案。 在SQL直接写入的场景下,用户可以通过开启数据导入模式,显著提升Insert、Delete和Update的执行效率;DTS完全适配了RDS DuckDB引擎的写入模型,实现了从MySQL到DuckDB的全量导入与增量同步。 总体而言,了解并合理使用这些能力,能够帮助用户在不显著增加迁移成本的情况下,获得更高的写入吞吐、更稳定的同步性能以及更优的资源利用效率。背景
RDS DuckDB高效写入原理
DuckDB写入路径
数据导入模式
duckdb_data_import_mode是会话级开关,负责把当前连接切换到一种受限的数据导入模式;duckdb_idempotent_data_import_enabled是全局开关,在前者基础上提供幂等导入能力。duckdb_data_import_mode只能在事务外修改,这一限制是为了防止在事务执行中写入模式发生变化,导致同一事务前后行为不一致。开启后,该参数对DML操作施加不同程度的约束:duckdb_idempotent_data_import_enabled提供幂等导入能力,但它本身只是全局开关,真正生效还必须与duckdb_data_import_mode同时开启。其核心思想是在原本的INSERT执行前,先执行主键的DELETE,确保重复导入同一批数据时不会产生重复行。若目标行原本不存在,前置的DELETE也不会有影响,即可满足幂等要求。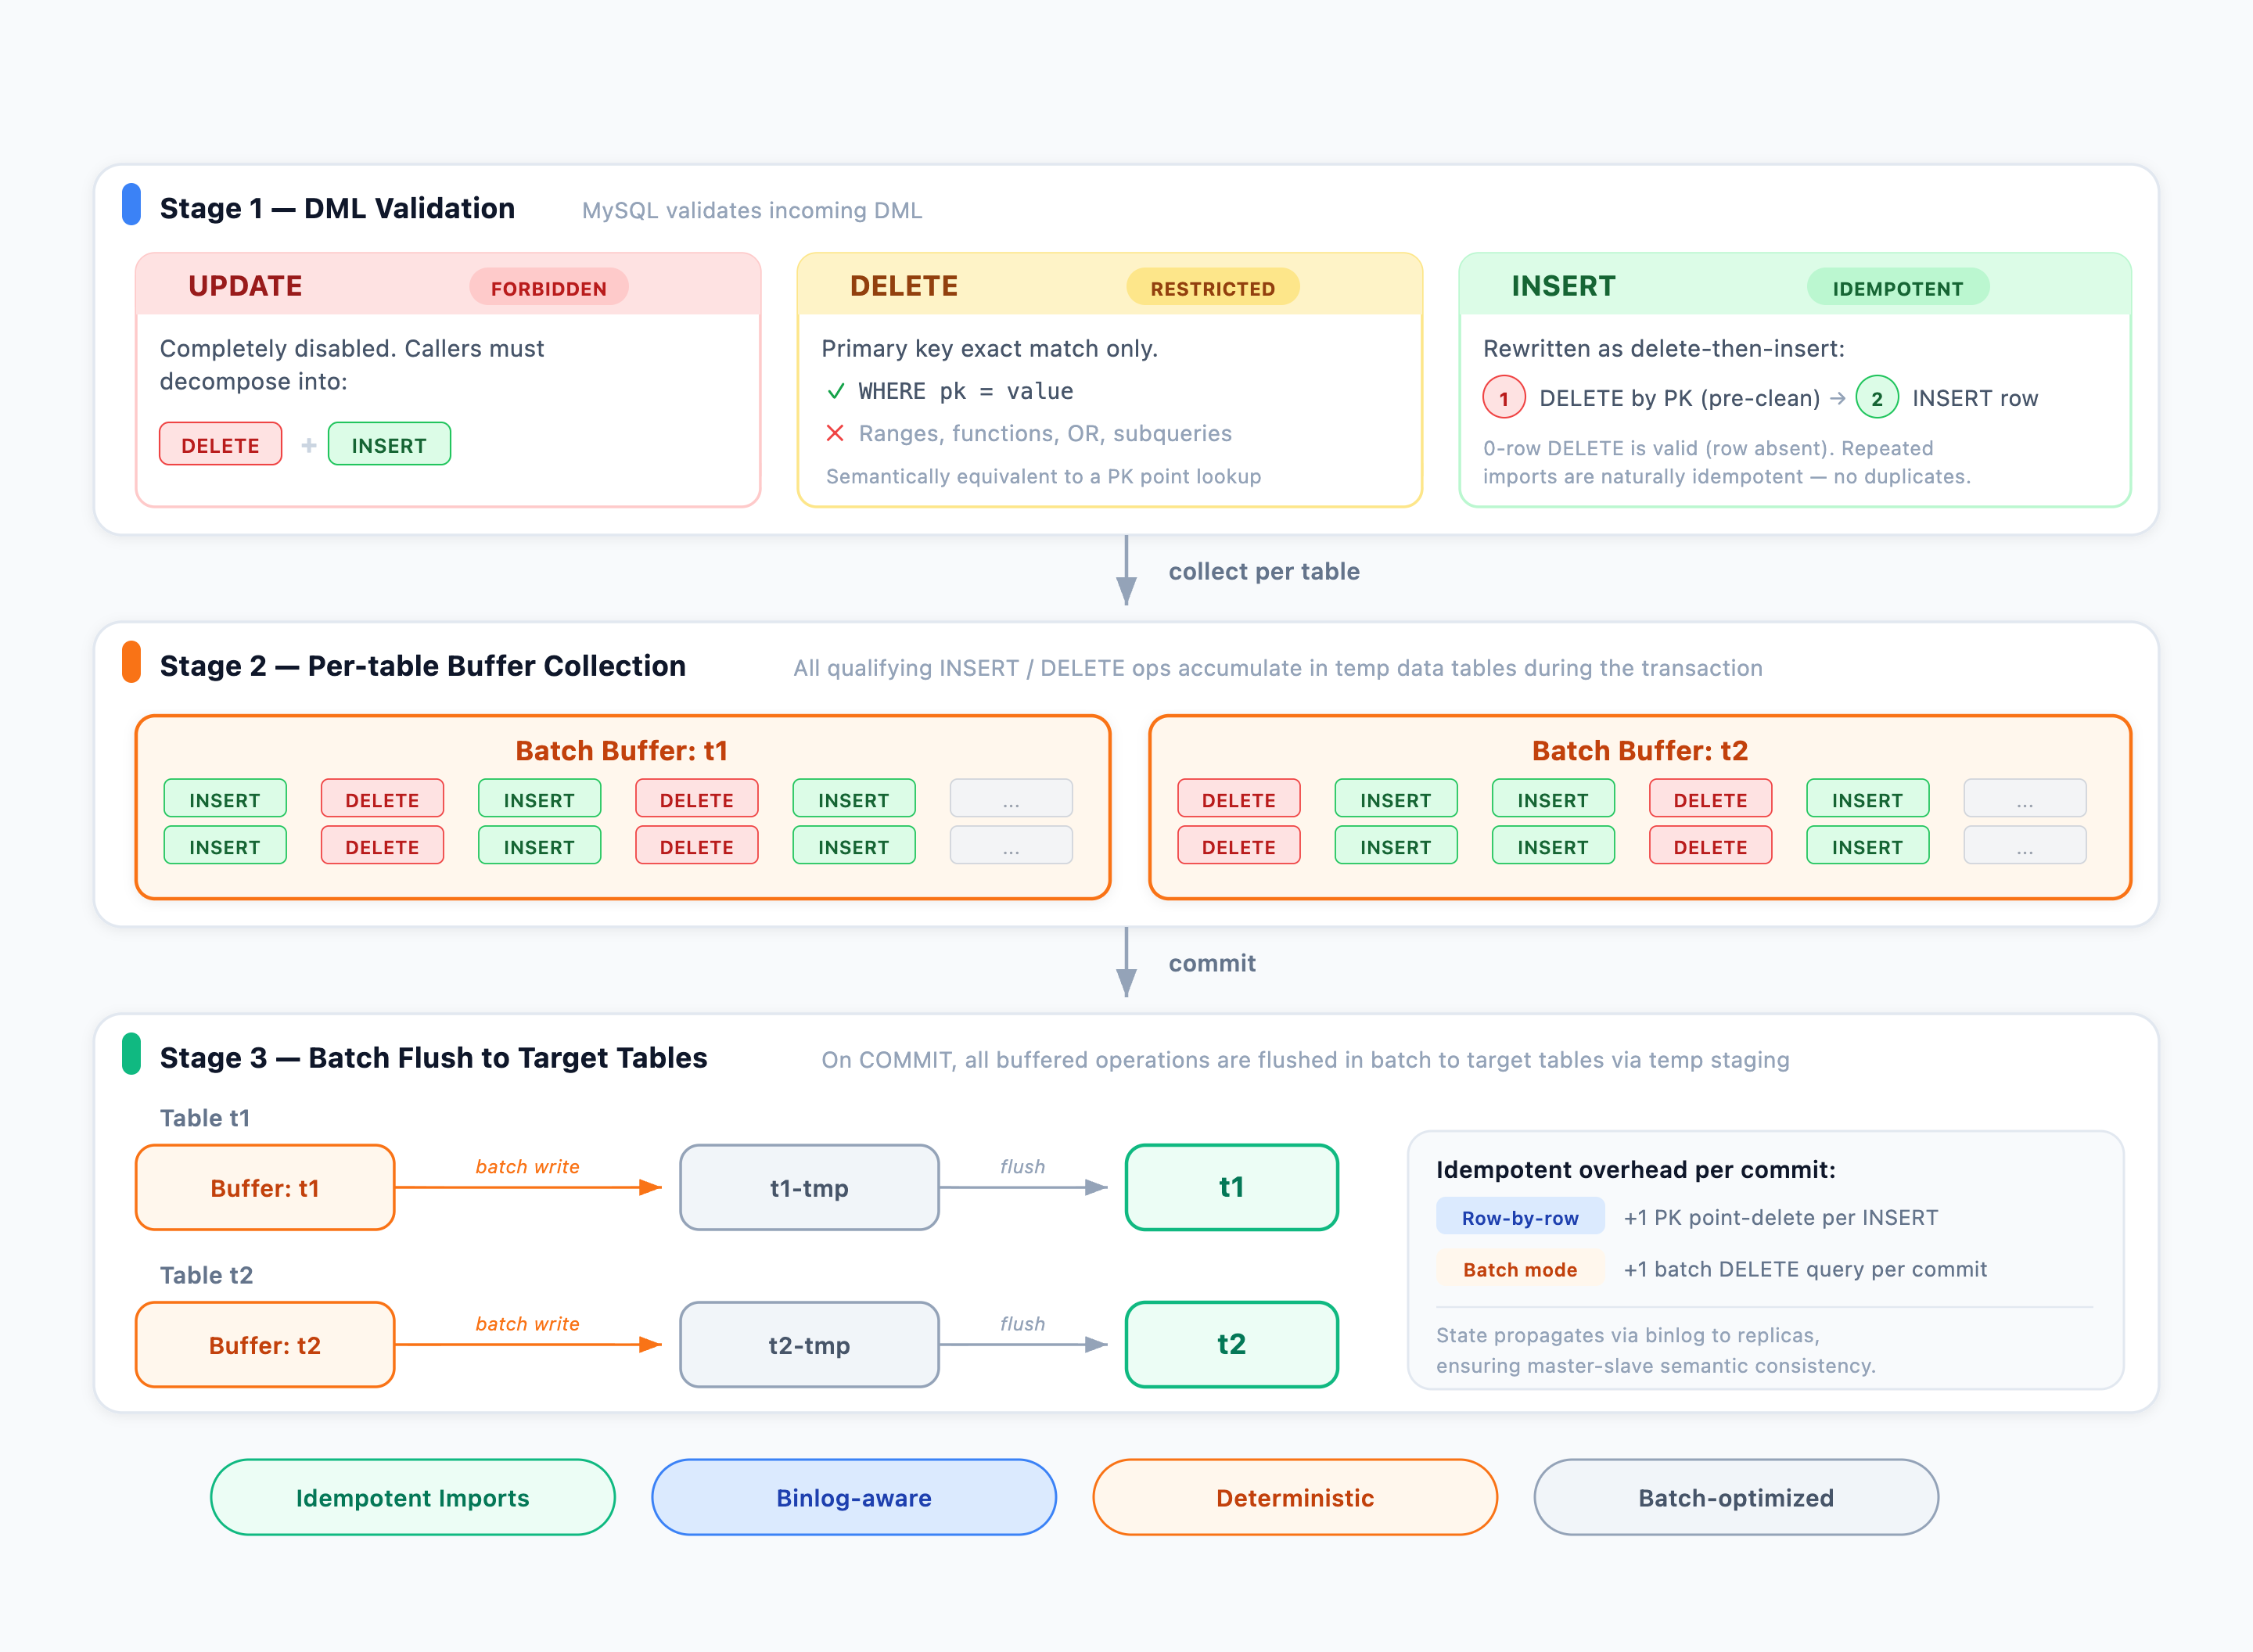
大事务优化
数据写入实践
直接写入
推荐配置
duckdb_dml_in_batchduckdb_data_import_modeduckdb_idempotent_data_import_enabledduckdb_dml_in_batch = ON、duckdb_idempotent_data_import_enabled = ON。-- 设置当前会话为数据导入模式
SET duckdb_data_import_mode = ON;
-- 开启事务
BEGIN;
-- 批量删除:以主键等值条件删除旧数据
DELETE FROM sbtest1 WHERE id = 1;
DELETE FROM sbtest1 WHERE id = 2;
-- ... 更多基于主键等值条件的删除操作
-- 批量插入新数据
INSERT INTO sbtest1 VALUES (1, 10086, '84508534114-47762074532-55498788399-83748899730-87507668724-45396778480-24213848632-90801272061-72458652754-27925662988', '02566560072-45713866725-23705174103-83819595699-82889105539');
INSERT INTO sbtest1 VALUES (2, 20010, '28573664250-67545473557-08943706871-02155529539-14819415454-26011853635-25822606553-46388637024-38264734637-25589297212', '87630225482-05348528698-26656306607-57609649599-86959697089');
-- ... 更多插入操作
-- 提交事务
COMMIT;
duckdb_data_import_mode参数不可在事务执行过程中变更,需在事务开启前完成设置。普通写入模式和数据导入模式性能对比
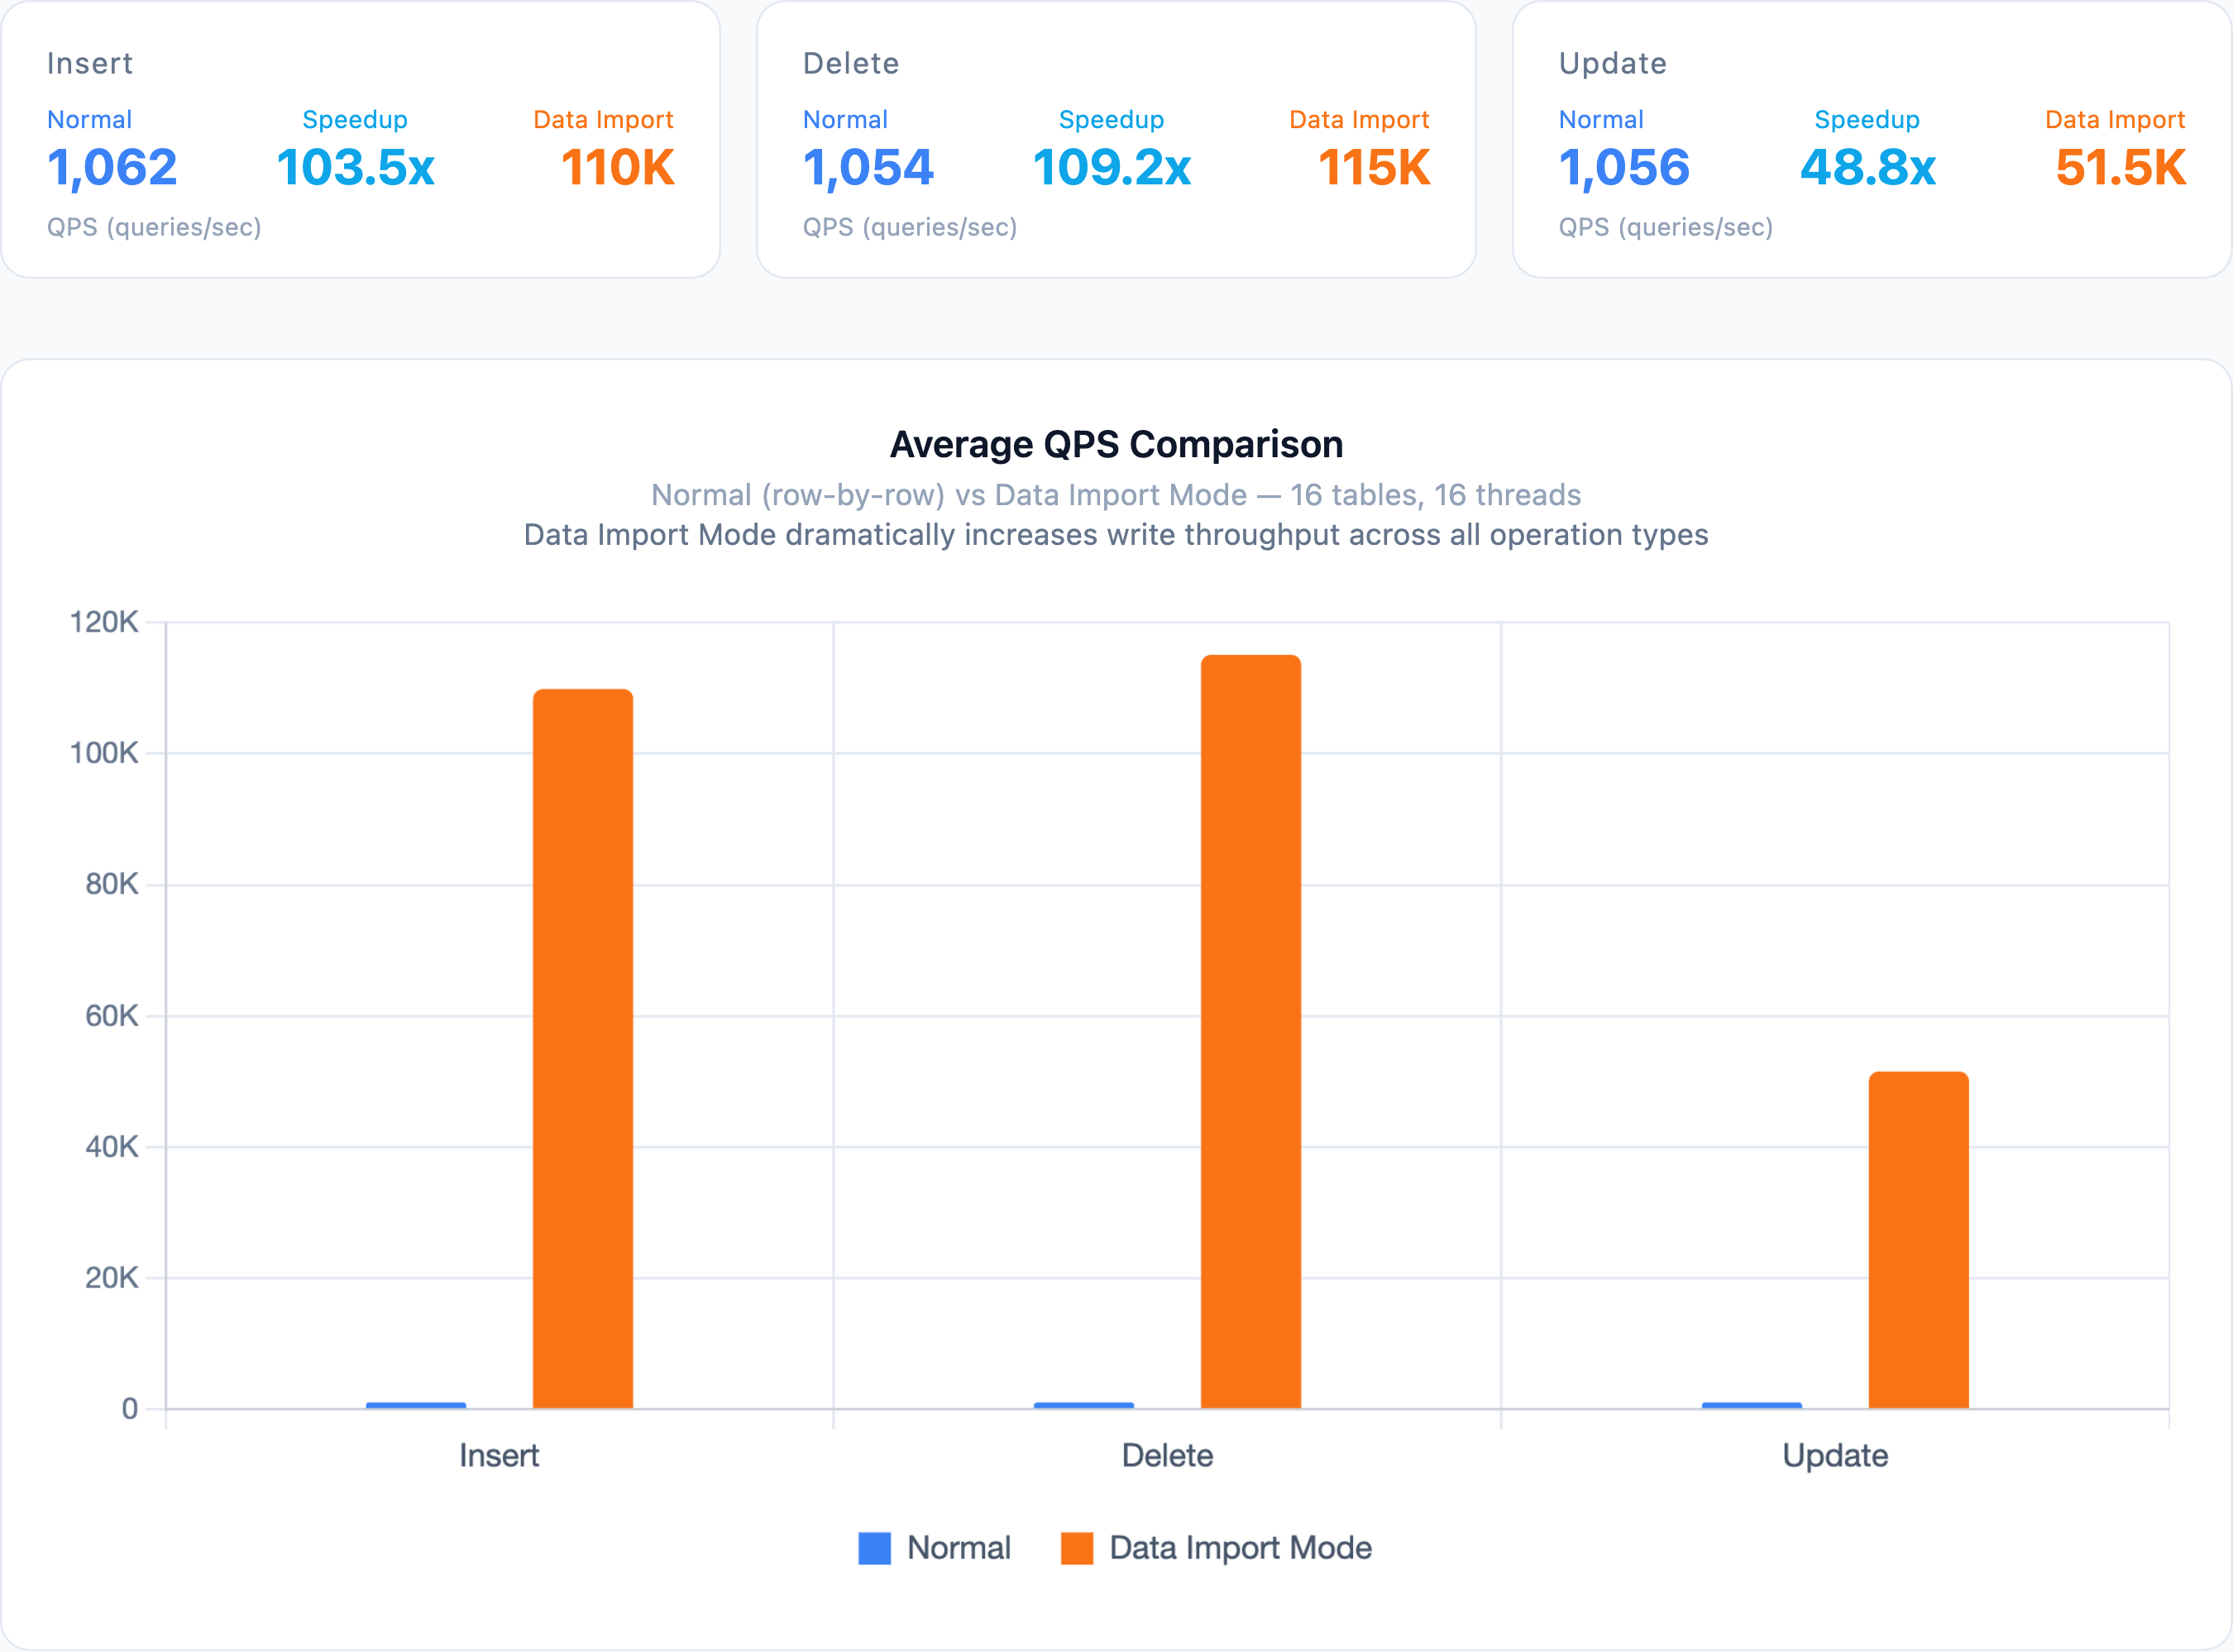
duckdb_dml_in_batch和duckdb_idempotent_data_import_enabled,并在会话内设置duckdb_data_import_mode = ON,以获得更好的吞吐表现和容错能力。DTS写入
同步原理
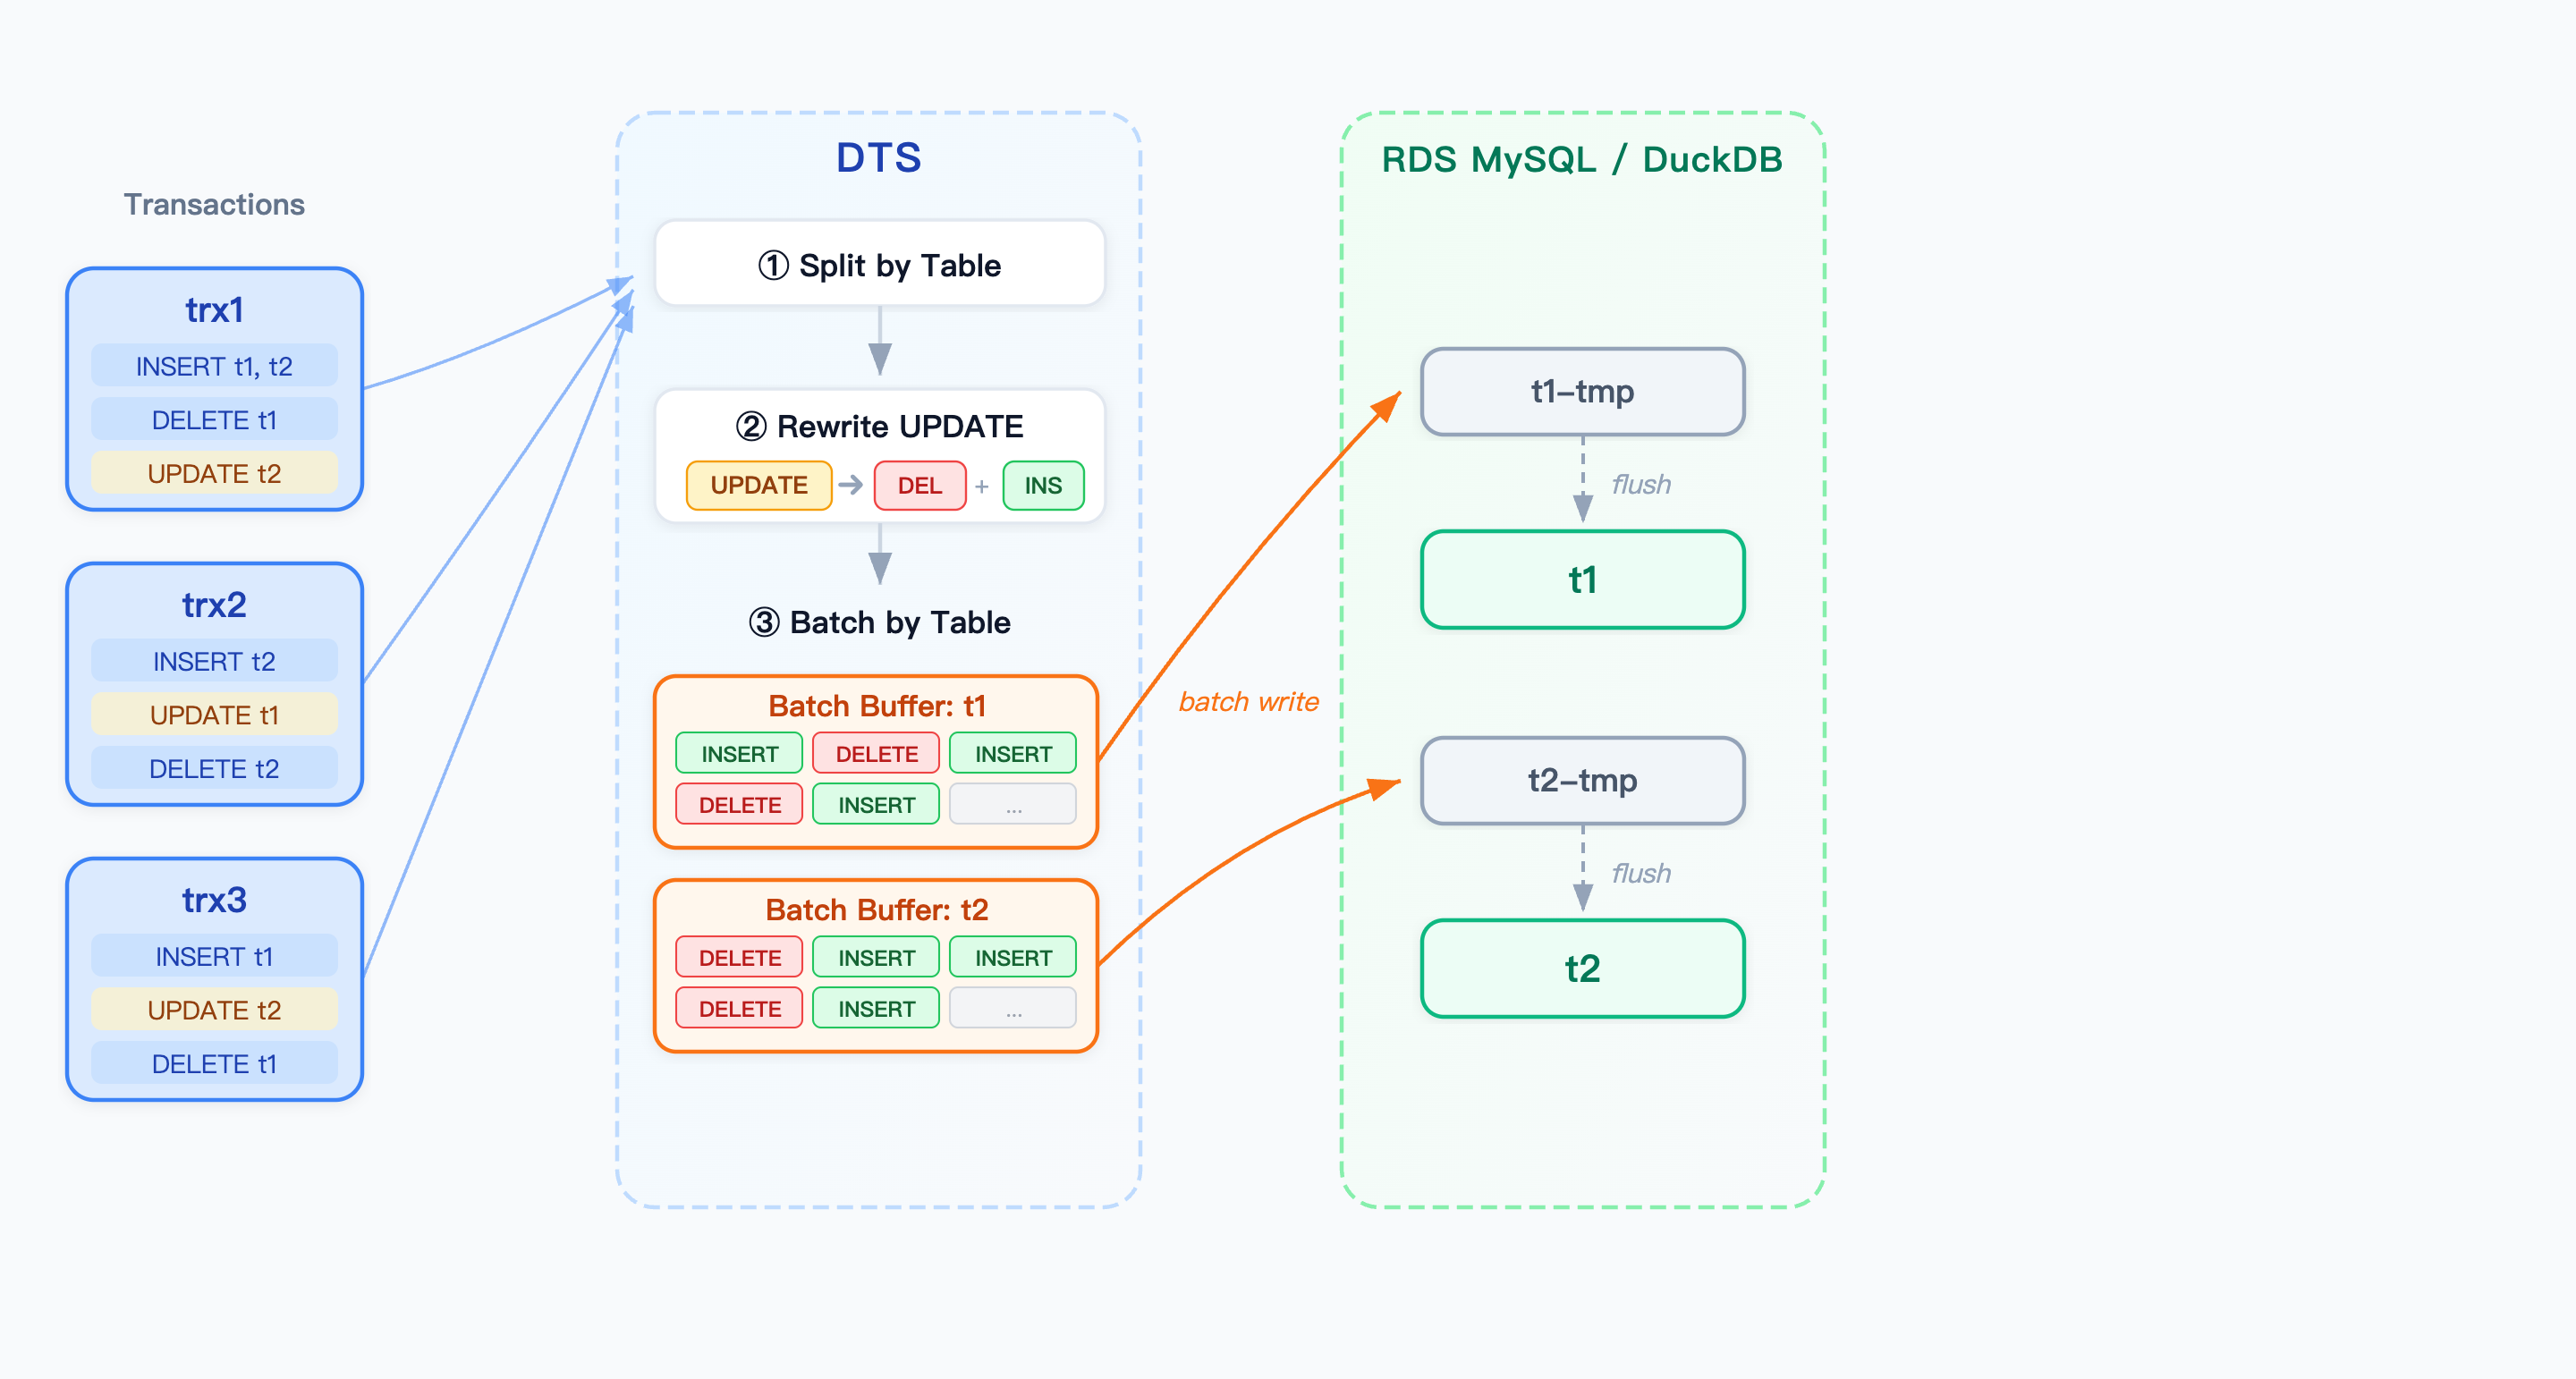
DTS同步性能测试
快速上手
结语