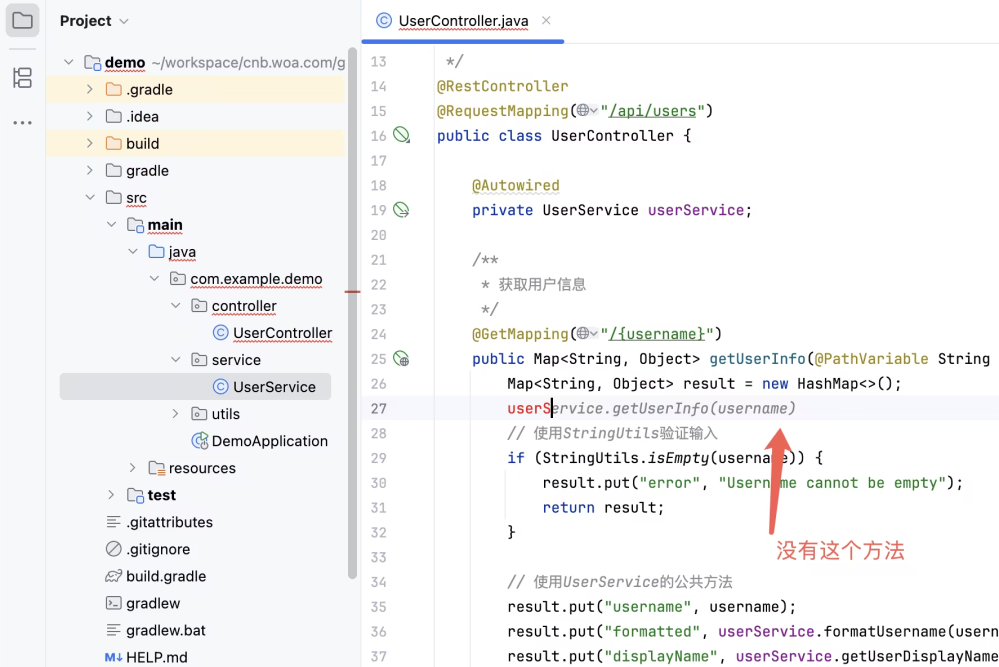
如下场景,因为没有把 UserService 加入上下文,所以没有提示有效的内容,出现了 UserService 内没有的方法。
打开文件后可以提示正确的方法:
整体思路是,考虑到开发人员在编码时会下意识地思考相关内容,所以设计也会比较简单。即优先选择打开的文件,通过算法判定这些文件和当前光标上下文的关联,从而给到模型进行排名和相似度计算。
提取所有可能相关的上下文,可能是当前文件、导入的文件、同一目录中的文件等中的代码等。
重新排名和相似度计算。具体的选择思路如下:离线场景选取文件的时候,会根据文件结构进行选择,在目录结构中越紧邻的文件越容易被选到;上线场景选择文件的时候,可以根据用户在编辑器中打开的文件进行选择,选择用户最近打开的n个文件;代码片段的选择思路,是根据 TF-IDF(一种信息检索领域的常用算法)进行代码片段的相关性匹配,选取比较相关的一段代码。
通过按排名顺序添加上下文片段来构建提示,直到填充代码补全模型的最大上下文长度。还有一些其他细节可确保模型将这些理解为不同的信息片段,但一旦构建完成,这些细节就会被发送到模型进行推理。
举例:
public class Example {}按以下步骤实践跨文件能力。下图是项目局部图,entity 定义了三个对象,他们彼此有对象关联。同时 User 类里的 ZipCode 需要从一个单例工厂中创建获得。
实体类大概是这样的:
打开 User.java、PhotoArts.java、Image.java,在 UserServiceImpl.java 里创建一个函数,通过跨文件的延展,可以正确生成多个文件的函数调用链。
视频如下:
定义了一个 CityFactory,它是一个单例工厂,用于转 ZipCode 方法。代码如下:
public class CityFactory {    private CityFactory() {    }
    private static class CityFactoryHolder {        private static CityFactory INSTANCE = new CityFactory();    }
    public static CityFactory getInstance() {        if (CityFactoryHolder.INSTANCE == null) {            synchronized (CityFactory.class) {                if (CityFactoryHolder.INSTANCE == null) {                    CityFactoryHolder.INSTANCE = new CityFactory();                }            }        }        return CityFactoryHolder.INSTANCE;    }
    public String getZipCodeByCity(String cityId) {        // load from database        // connect from database        return "12345";    }
}
通过查看补全内容,可以确定代码助手正确地理解了工厂类的调用,而不是简单的实例化。
本文用简单的示例,体现了跨文件补全的产品价值。扩展上下文的窗口, 引入更多的相关联的文件,从而让补全生成更精准,也更接近对项目工程当下的情境理解。